Azure OCR API: วิธีเชื่อมต่อระบบอ่านเอกสารเข้ากับแอปพลิเคชันทางธุรกิจ
ธุรกิจต่าง ๆ ต้องจัดการเอกสารในแทบทุกแผนก ทีมการเงินต้องประมวลผลใบแจ้งหนี้และใบเสร็จ ฝ่ายทรัพยากรบุคคลต้องจัดการใบสมัครและประวัติพนักงาน ขณะที่ทีมปฏิบัติการต้องทำงานกับใบสั่งซื้อ เอกสารจัดส่งสินค้า และสัญญาต่าง ๆ เมื่อข้อมูลเหล่านี้อยู่ในรูปแบบไฟล์ PDF ที่สแกนมา หรือรูปภาพ พนักงานมักต้องป้อนข้อมูลเดิมลงในแอปพลิเคชันทางธุรกิจด้วยตนเอง
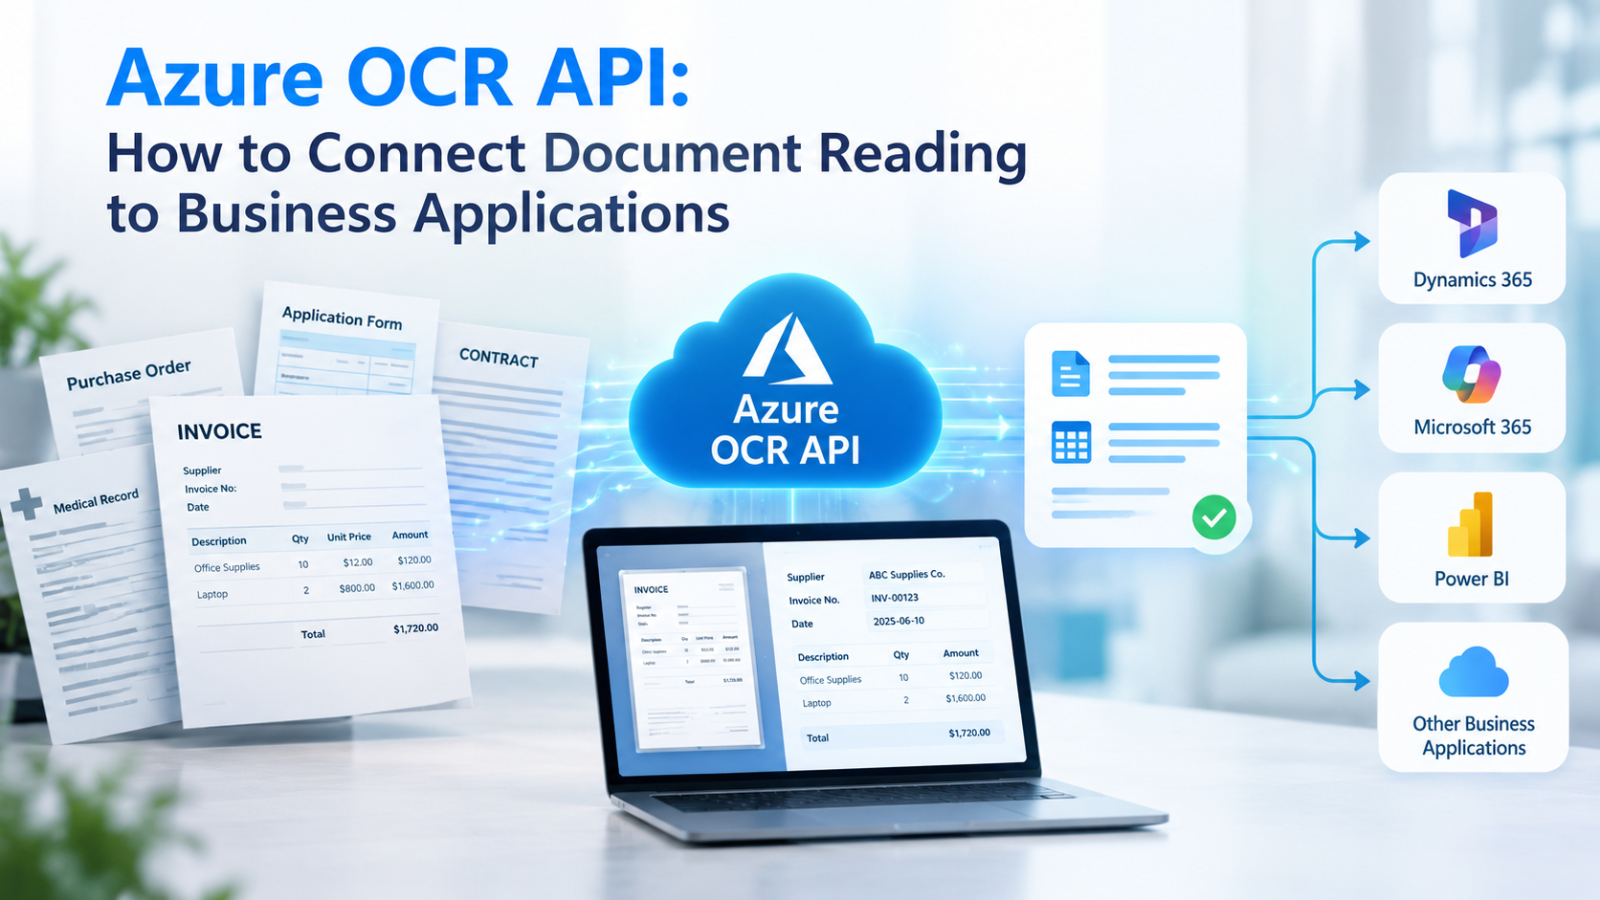
การเชื่อมต่อ Azure OCR API สามารถช่วยทำให้กระบวนการนี้เป็นระบบอัตโนมัติได้ โดยแปลงเนื้อหาในเอกสารให้เป็นข้อมูลที่คอมพิวเตอร์สามารถอ่านและประมวลผลได้ แทนที่จะมองเอกสารแต่ละฉบับเป็นเพียงไฟล์ที่ต้องเปิดอ่านและตรวจสอบด้วยตนเอง ธุรกิจสามารถสร้างเวิร์กโฟลว์ที่ดึงข้อมูลจากเอกสารและส่งต่อไปยังระบบที่ต้องการใช้งานได้โดยอัตโนมัติ
Azure OCR API คืออะไร?
Azure OCR API ช่วยให้แอปพลิเคชันสามารถใช้ความสามารถด้านการรู้จำข้อความบนคลาวด์ของ Microsoft เพื่อดึงข้อความจากรูปภาพและเอกสารได้ ทั้งนี้ ขึ้นอยู่กับบริการที่เลือก ธุรกิจสามารถใช้บริการเพื่อรู้จำข้อความที่พิมพ์ไว้ ประมวลผลไฟล์ PDF ที่ผ่านการสแกน และรับข้อมูลเกี่ยวกับบรรทัดข้อความ คำ และตำแหน่งของข้อความในเอกสาร
สำหรับเวิร์กโฟลว์ที่ต้องจัดการเอกสารจำนวนมาก Azure AI Document Intelligence มีความสามารถด้าน OCR พร้อมฟีเจอร์เพิ่มเติมสำหรับทำความเข้าใจโครงสร้างเอกสารและดึงข้อมูลที่มีรูปแบบชัดเจน นักพัฒนาสามารถเชื่อมต่อความสามารถเหล่านี้ผ่าน REST API หรือชุดเครื่องมือพัฒนาซอฟต์แวร์ (SDK) ที่รองรับ
ตัวอย่างเช่น เมื่อซัพพลายเออร์ส่งใบแจ้งหนี้ในรูปแบบไฟล์ PDF ที่สแกนมา บริการ OCR สามารถรู้จำข้อความ เช่น ชื่อซัพพลายเออร์ หมายเลขใบแจ้งหนี้ วันที่ และยอดเงินรวม จากนั้นแอปพลิเคชันสามารถนำข้อมูลที่ดึงออกมาไปใช้เป็นจุดเริ่มต้นสำหรับการประมวลผลขั้นตอนต่อไปได้
สิ่งสำคัญคือ ต้องแยกความแตกต่างระหว่างการรู้จำข้อความ (Text Recognition) กับการดึงข้อมูล (Data Extraction) ให้ชัดเจน OCR ทำหน้าที่ระบุข้อความในเอกสาร แต่แอปพลิเคชันทางธุรกิจอาจต้องระบุเพิ่มเติมว่าค่าใดคือหมายเลขใบแจ้งหนี้ ตรวจสอบยอดเงินรวม และค้นหาข้อมูลซัพพลายเออร์ที่ตรงกับฐานข้อมูล ขั้นตอนเหล่านี้อาจต้องอาศัยความสามารถในการทำความเข้าใจเอกสาร กฎทางธุรกิจ หรือการประมวลผลเพิ่มเติมภายในแอปพลิเคชัน
Azure OCR API Integration ทำงานอย่างไร?
การเชื่อมต่อโดยทั่วไปจะรวมแหล่งที่มาของเอกสาร บริการ OCR ตรรกะการประมวลผลของแอปพลิเคชัน และระบบปลายทางเข้าไว้ในเวิร์กโฟลว์เดียวกัน
- รับเอกสารจากแอปพลิเคชันทางธุรกิจ
กระบวนการเริ่มต้นเมื่อมีเอกสารเข้าสู่องค์กร ซึ่งอาจเป็นเอกสารที่อัปโหลดผ่านเว็บแอปพลิเคชัน ได้รับทางอีเมล สแกนจากสำนักงาน หรือส่งผ่านพอร์ทัลสำหรับลูกค้า
แอปพลิเคชันควรจัดเก็บไฟล์ต้นฉบับอย่างปลอดภัยและสร้างคำขอสำหรับประมวลผลเอกสาร พร้อมบันทึกข้อมูลที่จำเป็น เช่น วันที่ส่งเอกสาร ประเภทเอกสาร แผนกที่เกี่ยวข้อง และสถานะการประมวลผล
สำหรับองค์กรที่ต้องประมวลผลเอกสารปริมาณมาก การใช้คิวงานหรือบริการประมวลผลเบื้องหลังจะช่วยป้องกันไม่ให้การประมวลผลเอกสารทำให้แอปพลิเคชันหลักทำงานช้าลง
- ส่งเอกสารไปยังบริการ OCR
แอปพลิเคชันจะส่งเอกสารไปยัง Azure OCR Endpoint ที่เหมาะสมผ่านคำขอ API ที่มีการยืนยันตัวตน
วิธีการเชื่อมต่อขึ้นอยู่กับบริการที่เลือกและประเภทของเอกสาร โดย Azure AI Document Intelligence รองรับการประมวลผลเอกสารผ่าน Read Model รวมถึงโมเดลอื่น ๆ ที่ออกแบบมาเพื่อดึงข้อมูลตามลักษณะงานเฉพาะ
สำหรับการวิเคราะห์แบบอะซิงโครนัส (Asynchronous Analysis) ที่รองรับ แอปพลิเคชันจะส่งคำขอและได้รับรหัสอ้างอิงของงาน จากนั้นจึงตรวจสอบสถานะการประมวลผลและดึงผลลัพธ์เมื่อการวิเคราะห์เสร็จสมบูรณ์
นักพัฒนาควรอ้างอิงเอกสารประกอบของ API เวอร์ชันที่ใช้งานอยู่ เนื่องจาก OCR Endpoint แต่ละประเภทอาจมีรูปแบบคำขอและวิธีประมวลผลที่แตกต่างกัน
- แปลงผลลัพธ์ OCR ให้เป็นข้อมูลที่มีโครงสร้าง
ผลลัพธ์จาก OCR ไม่ได้พร้อมใช้งานในระบบธุรกิจโดยตรงเสมอไป เอกสารหนึ่งฉบับอาจมีข้อความหลายบรรทัด แต่ระบบปลายทางมักต้องการข้อมูลเฉพาะในแต่ละฟิลด์
ตัวอย่างเช่น ใบแจ้งหนี้จากซัพพลายเออร์อาจมีข้อมูลดังต่อไปนี้
ฟิลด์ข้อมูล | ตัวอย่างข้อมูลที่ดึงได้ |
ชื่อซัพพลายเออร์ | ABC Manufacturing |
หมายเลขใบแจ้งหนี้ | INV-2026-0158 |
วันที่ออกใบแจ้งหนี้ | 15 ตุลาคม 2026 |
ยอดเงินรวม | 25,500.00 |
สกุลเงิน | THB |
ชั้นการเชื่อมต่อระบบ (Integration Layer) จะทำหน้าที่จับคู่ข้อมูลที่รู้จำได้เข้ากับฟิลด์ที่ระบบปลายทางต้องการ โดยขึ้นอยู่กับประเภทเอกสารและบริการที่ใช้ กระบวนการนี้อาจต้องอาศัยการวิเคราะห์โครงสร้างเอกสาร โมเดลสำเร็จรูปสำหรับการดึงข้อมูล โมเดลที่ปรับแต่งเฉพาะ หรือกฎทางธุรกิจที่กำหนดขึ้นเอง
แอปพลิเคชันควรปรับรูปแบบวันที่ ตัวเลข สกุลเงิน และข้อมูลอื่น ๆ ให้ตรงกับรูปแบบที่ระบบปลายทางรองรับ เพื่อป้องกันความแตกต่างของรูปแบบข้อมูลในเอกสารแต่ละฉบับ ซึ่งอาจทำให้ข้อมูลในระบบไม่สอดคล้องกัน
- ตรวจสอบความถูกต้องของข้อมูลที่ดึงออกมา
ไม่ควรถือว่าข้อความที่ OCR รู้จำได้เป็นข้อมูลทางธุรกิจที่ถูกต้องโดยอัตโนมัติ
เวิร์กโฟลว์ที่มีประสิทธิภาพควรตรวจสอบฟิลด์ที่จำเป็น ตรวจสอบรูปแบบข้อมูล เปรียบเทียบรหัสซัพพลายเออร์กับข้อมูลที่มีอยู่ และตรวจสอบการคำนวณตามความเหมาะสม โดยสามารถใช้ค่าความเชื่อมั่นของผลการรู้จำ (Confidence Information) ร่วมกับกฎทางธุรกิจเพื่อพิจารณาว่าข้อมูลพร้อมสำหรับการประมวลผลอัตโนมัติหรือไม่
เอกสารที่มีข้อมูลไม่ครบถ้วน ข้อความไม่ชัดเจน หรือข้อมูลไม่สอดคล้องกัน ควรถูกส่งให้พนักงานตรวจสอบ โดยเฉพาะในกระบวนการด้านการเงิน กฎหมาย และงานประเภทอื่น ๆ ที่ข้อมูลผิดพลาดอาจส่งผลกระทบอย่างมีนัยสำคัญ
- ส่งข้อมูลไปยังแอปพลิเคชันปลายทาง
หลังจากตรวจสอบความถูกต้องแล้ว ชั้นการเชื่อมต่อระบบจะส่งข้อมูลที่มีโครงสร้างไปยังระบบธุรกิจที่เกี่ยวข้อง
ระบบปลายทางอาจเป็นแพลตฟอร์ม ERP ซอฟต์แวร์บัญชี แอปพลิเคชัน HR ฐานข้อมูล ระบบจัดการเอกสาร หรือเว็บแอปพลิเคชันภายในองค์กร ขึ้นอยู่กับสถาปัตยกรรมระบบของแต่ละธุรกิจ
จากนั้นระบบปลายทางสามารถสร้างร่างใบแจ้งหนี้ อัปเดตข้อมูล เริ่มกระบวนการอนุมัติ หรือทำให้ข้อมูลที่ดึงออกมาพร้อมสำหรับการค้นหาและจัดทำรายงาน
ทั้งนี้ ควรเชื่อมโยงไฟล์เอกสารต้นฉบับเข้ากับรายการข้อมูลที่ผ่านการประมวลผลแล้ว เพื่อให้พนักงานสามารถตรวจสอบแหล่งที่มาของข้อมูลได้เมื่อจำเป็น
ตัวอย่าง: การทำระบบประมวลผลใบแจ้งหนี้อัตโนมัติด้วย Azure OCR API
ลองจินตนาการว่าทีมการเงินของคุณต้องประมวลผลใบแจ้งหนี้หลายร้อยฉบับในแต่ละเดือน แทนที่จะคัดลอกข้อมูลจากไฟล์ PDF ไปยังซอฟต์แวร์บัญชีด้วยตนเอง เวิร์กโฟลว์ที่ใช้ OCR สามารถช่วยจัดการงานประจำส่วนใหญ่ได้โดยอัตโนมัติ
กระบวนการทำงานมีดังนี้
- รับเอกสาร (Capture): รับใบแจ้งหนี้ผ่านอีเมลหรือการอัปโหลดไฟล์
- ดึงข้อมูล (Extract): รู้จำชื่อซัพพลายเออร์ หมายเลขใบแจ้งหนี้ วันที่ และยอดเงินรวม
- ตรวจสอบ (Validate): ตรวจสอบฟิลด์ที่จำเป็นและจับคู่ข้อมูลซัพพลายเออร์
- เชื่อมต่อระบบ (Integrate): ส่งข้อมูลที่ผ่านการตรวจสอบไปยังระบบบัญชีหรือ ERP
- อนุมัติ (Approve): ส่งใบแจ้งหนี้เข้าสู่กระบวนการอนุมัติ หรือแจ้งเตือนเมื่อพบข้อยกเว้นที่ต้องให้พนักงานตรวจสอบ
ผลลัพธ์คือ ลดการป้อนข้อมูลด้วยตนเอง ลดงานซ้ำซ้อน และทำให้กระบวนการอนุมัติใบแจ้งหนี้มีประสิทธิภาพมากขึ้น แนวทางเดียวกันนี้ยังสามารถนำไปใช้กับการประมวลผลใบเสร็จ ใบสั่งซื้อ และแบบฟอร์มของลูกค้าได้อีกด้วย
ปัจจัยสำคัญที่ควรพิจารณาในการเชื่อมต่อ Azure OCR API
การเชื่อมต่อ OCR เข้ากับแอปพลิเคชันทางธุรกิจต้องอาศัยมากกว่าความสามารถในการรู้จำข้อความ ปัจจัย 4 ประการต่อไปนี้สามารถสร้างความแตกต่างระหว่างระบบที่ใช้งานได้ทั่วไปกับโซลูชันทางธุรกิจที่เชื่อถือได้
เลือกโมเดล OCR ให้เหมาะสม
เลือกบริการให้สอดคล้องกับประเภทเอกสารที่ต้องประมวลผล การรู้จำข้อความทั่วไปอาจเพียงพอสำหรับเอกสารที่มีโครงสร้างไม่ซับซ้อน ขณะที่ใบแจ้งหนี้และแบบฟอร์มอาจต้องใช้ความสามารถในการดึงข้อมูลเฉพาะทาง ควรทดสอบด้วยเอกสารจริงเสมอ รวมถึงเอกสารที่มีทั้งภาษาไทยและภาษาอังกฤษ หากเกี่ยวข้องกับการใช้งานขององค์กร
รักษาความปลอดภัยของข้อมูล
ปกป้องข้อมูลรับรองสำหรับ API ควบคุมสิทธิ์การเข้าถึง และกำหนดนโยบายการเก็บรักษาและการเข้ารหัสข้อมูลอย่างเหมาะสม โดยเฉพาะเมื่อระบบต้องประมวลผลข้อมูลทางการเงินหรือข้อมูลส่วนบุคคล
วางแผนรับมือข้อผิดพลาดและการขยายระบบ
เอกสารที่สแกนด้วยคุณภาพต่ำ ความล้มเหลวของเครือข่าย และการส่งเอกสารซ้ำ อาจทำให้เวิร์กโฟลว์หยุดชะงักได้ ควรออกแบบระบบให้รองรับการจัดการข้อผิดพลาด กลไกการลองใหม่ (Retry Mechanism) และการติดตามสถานะการประมวลผล เพื่อให้เอกสารดำเนินไปตามขั้นตอนได้อย่างต่อเนื่อง
วัดผลลัพธ์ที่เกิดขึ้นจริง
ติดตามความแม่นยำในการดึงข้อมูล ระยะเวลาประมวลผล อัตราการส่งเอกสารให้พนักงานตรวจสอบ และจำนวนชั่วโมงการทำงานที่ประหยัดได้ ตัวชี้วัดเหล่านี้ช่วยให้องค์กรประเมินได้ว่าระบบอัตโนมัติช่วยเพิ่มประสิทธิภาพการทำงานได้จริงหรือไม่
Azure OCR API กับโซลูชันประมวลผลเอกสารแบบครบวงจร
OCR API มีเทคโนโลยีสำหรับรู้จำข้อความ แต่เวิร์กโฟลว์ทางธุรกิจที่สมบูรณ์อาจต้องการความสามารถเพิ่มเติม เช่น การตรวจสอบข้อมูล การจัดประเภทเอกสาร การส่งต่อเพื่ออนุมัติ และการเชื่อมต่อกับระบบอื่น ๆ
การพัฒนาส่วนประกอบทั้งหมดขึ้นมาเองช่วยให้องค์กรปรับแต่งระบบได้อย่างยืดหยุ่น แต่ก็ต้องใช้ทรัพยากรในการพัฒนาและบำรุงรักษาอย่างต่อเนื่อง ในทางกลับกัน โซลูชันที่รวมความสามารถด้านการประมวลผลเอกสารไว้ด้วยกันอาจช่วยลดภาระดังกล่าวได้
หัวใจสำคัญคือ การเลือกแนวทางที่สามารถเปลี่ยนเอกสารให้เป็นข้อมูลทางธุรกิจที่นำไปใช้งานได้จริง ไม่ใช่เพียงแปลงเอกสารให้กลายเป็นข้อความที่อ่านได้เท่านั้น
ยกระดับการเชื่อมต่อเอกสารด้วย DOVA OCR
สำหรับธุรกิจที่ต้องการทำให้การประมวลผลเอกสารเป็นระบบอัตโนมัติ โดยไม่ต้องพัฒนาส่วนประกอบทุกอย่างขึ้นมาเอง DOVA OCR นำเสนอแพลตฟอร์ม Document Intelligence ที่ขับเคลื่อนด้วย AI และพัฒนาบน Microsoft Azure
DOVA รองรับการรู้จำข้อความภาษาไทยและภาษาอังกฤษ รวมถึงภาษาอื่น ๆ การดึงข้อความและข้อมูลจากเอกสาร และการเชื่อมต่อกับระบบภายนอกผ่าน External Connector นอกจากนี้ ยังมีขั้นตอนการตรวจสอบข้อมูลโดยมนุษย์ เพื่อช่วยให้ผู้ใช้งานตรวจสอบข้อมูลที่ดึงออกมาได้ก่อนส่งต่อไปยังขั้นตอนถัดไปของเวิร์กโฟลว์ ความสามารถเหล่านี้สามารถนำไปประยุกต์ใช้กับกระบวนการทำงานที่ต้องจัดการเอกสารจำนวนมากในฝ่ายการเงิน ฝ่ายทรัพยากรบุคคล และฝ่ายปฏิบัติการ
แทนที่จะมุ่งเน้นเพียงการแปลงรูปภาพเป็นข้อความ ธุรกิจสามารถใช้ DOVA เป็นส่วนหนึ่งของแนวทางการเปลี่ยนเอกสารให้เป็นข้อมูลที่มีโครงสร้าง ซึ่งตรวจสอบ จัดการ และเชื่อมต่อกับแอปพลิเคชันที่ใช้งานอยู่ได้ง่ายขึ้น
หากองค์กรของคุณกำลังมองหาวิธีลดการป้อนข้อมูลด้วยตนเอง เพิ่มประสิทธิภาพการจัดการเอกสาร และเชื่อมโยงข้อมูลจากเอกสารเข้ากับเวิร์กโฟลว์ทางธุรกิจ สามารถศึกษาเพิ่มเติมเกี่ยวกับ DOVA OCR เพื่อเรียนรู้ว่าเทคโนโลยี Document Intelligence จะช่วยสนับสนุนเป้าหมายการเปลี่ยนผ่านสู่ดิจิทัลขององค์กรได้อย่างไร
Related Articles
- Microsoft 365 คืออะไร?
- OCR Software คืออะไร?
- โปรแกรม OCR ภาษาไทย – DOVA OCR
- OCR เอกสารทางการแพทย์: Reduce Data Entry and Improve Document Management
- Automated Receipt Scanning: Reduce Data Entry and Speed Up Expense Reimbursements
- What Is Automated Document Data Extraction? Turn Documents into Usable Data
Frequently Asked Questions (FAQ)
DOVA OCR รองรับเอกสารประเภทใดบ้าง?
DOVA OCR สามารถช่วยประมวลผลเอกสารทางธุรกิจ เช่น ใบแจ้งหนี้ ใบเสร็จรับเงิน แบบฟอร์ม และเอกสารที่สแกนเป็นไฟล์ดิจิทัล ช่วยให้การจัดการข้อมูลสะดวกและมีประสิทธิภาพมากขึ้น
DOVA OCR ช่วยลดขั้นตอนการทำงานของพนักงานได้อย่างไร?
ระบบช่วยอ่านข้อความและดึงข้อมูลสำคัญจากเอกสาร ลดการป้อนข้อมูลด้วยมือ และช่วยให้พนักงานใช้เวลากับการตรวจสอบข้อมูลและงานที่ต้องอาศัยการตัดสินใจได้มากขึ้น
ข้อมูลที่ระบบอ่านได้มีความแม่นยำแค่ไหน?
ความแม่นยำขึ้นอยู่กับคุณภาพของเอกสาร รูปแบบตัวอักษร และความซับซ้อนของข้อมูล ควรตรวจสอบผลลัพธ์ก่อนนำไปใช้งาน โดยเฉพาะข้อมูลทางการเงินหรือข้อมูลสำคัญขององค์กร
DOVA OCR สามารถเชื่อมต่อกับระบบงานเดิมขององค์กรได้หรือไม่?
DOVA OCR รองรับความสามารถ เช่น การส่งออกข้อมูลเป็น CSV การจัดเก็บข้อมูลในฐานข้อมูล และ RESTful API ซึ่งสามารถนำไปใช้เชื่อมต่อกับระบบอื่นได้ตามความเหมาะสมของการติดตั้ง
ธุรกิจควรเตรียมตัวอย่างไรก่อนเริ่มใช้งาน DOVA OCR?
ควรเริ่มจากการระบุประเภทเอกสารที่ต้องการประมวลผล เตรียมตัวอย่างเอกสารจริง และทดสอบความแม่นยำในการดึงข้อมูล รวมถึงตรวจสอบความต้องการด้านความปลอดภัยและการเชื่อมต่อระบบ เพื่อให้เลือกแนวทางใช้งานได้เหมาะสมกับองค์กร