ระบบดึงข้อมูลจากเอกสารอัตโนมัติ เปลี่ยนเอกสารเป็นข้อมูลดิจิทัล | DOVA
ธุรกิจต้องจัดการเอกสารจำนวนมากในแต่ละวัน ไม่ว่าจะเป็นใบแจ้งหนี้ ใบเสร็จรับเงิน ใบสั่งซื้อ แบบฟอร์มใบสมัคร และสัญญาต่าง ๆ แม้เอกสารเหล่านี้จะมีข้อมูลสำคัญ แต่การดึงข้อมูลด้วยตนเองอาจใช้เวลาอันมีค่าและเพิ่มความเสี่ยงที่จะเกิดข้อผิดพลาดในการป้อนข้อมูล
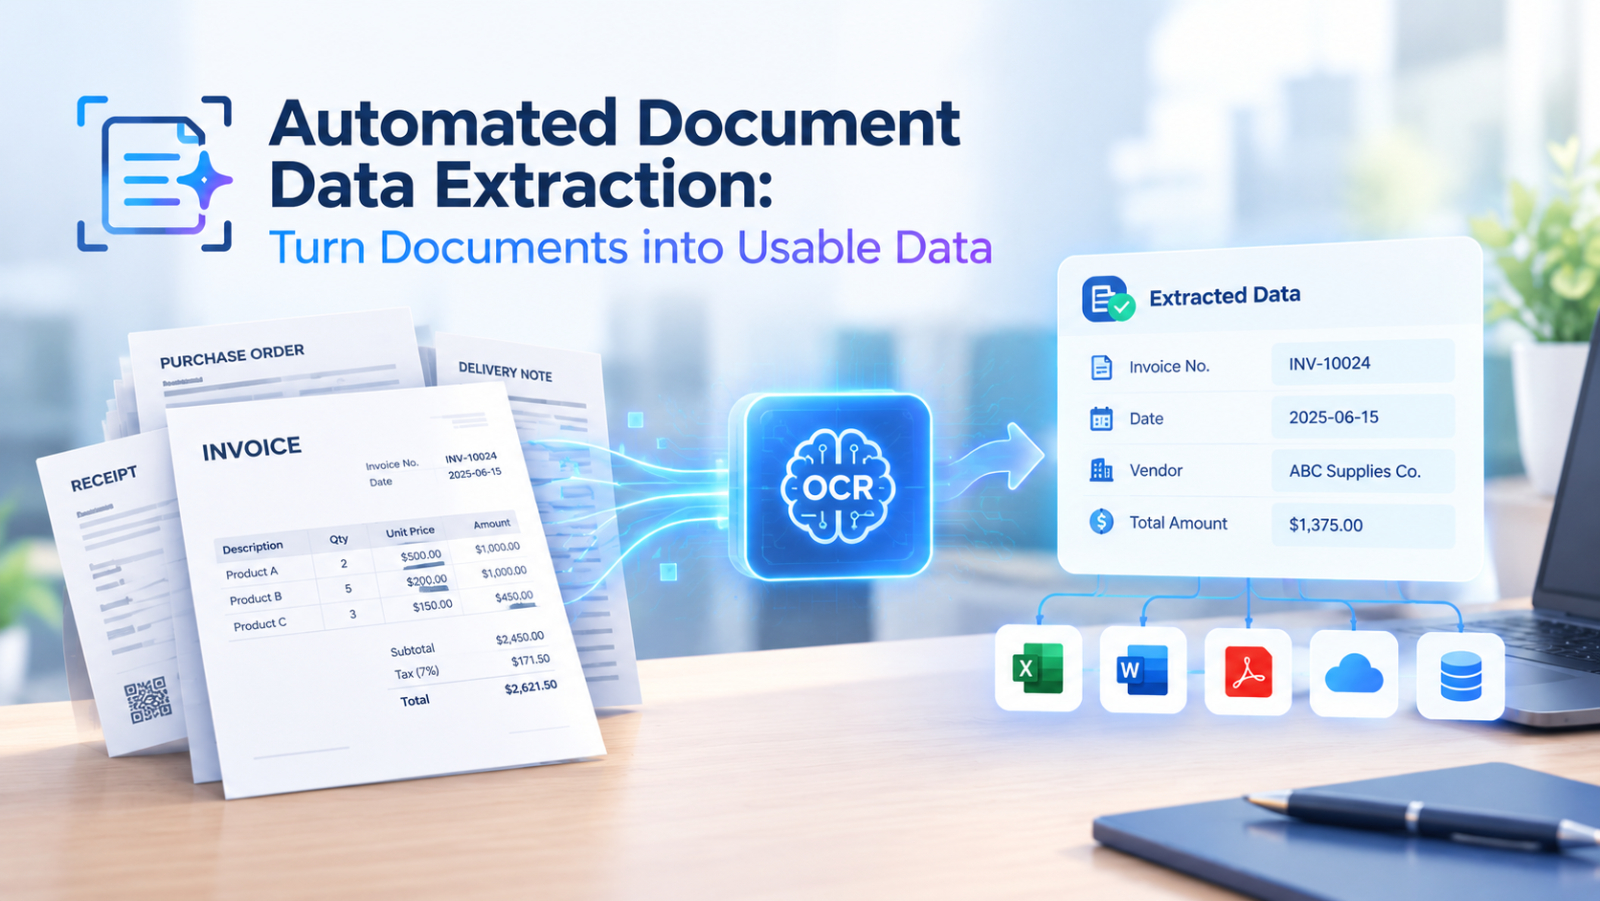
ระบบดึงข้อมูลจากเอกสารอัตโนมัติ ช่วยให้องค์กรแปลงข้อมูลจากเอกสารให้เป็นข้อมูลดิจิทัลที่มีโครงสร้างและสามารถนำไปใช้ในแอปพลิเคชันทางธุรกิจได้ แทนที่จะต้องพิมพ์ข้อมูลทุกช่องด้วยตนเอง พนักงานสามารถใช้เทคโนโลยีประมวลผลเอกสารเพื่อจดจำข้อความ ระบุข้อมูลที่เกี่ยวข้อง และเตรียมข้อมูลให้พร้อมสำหรับการประมวลผลในขั้นตอนถัดไป
โซลูชันอย่าง DOVA OCR ช่วยให้ธุรกิจก้าวข้ามข้อจำกัดของการจดจำข้อความทั่วไป ด้วยความสามารถในการดึงข้อมูลจากเอกสาร จำแนกประเภท ตรวจสอบข้อมูล และเชื่อมต่อกับเวิร์กโฟลว์ที่มีอยู่
ระบบดึงข้อมูลจากเอกสารอัตโนมัติคืออะไร?
ระบบดึงข้อมูลจากเอกสารอัตโนมัติ (Automated Document Data Extraction) คือกระบวนการระบุและรวบรวมข้อมูลเฉพาะจากเอกสาร โดยลดความจำเป็นในการป้อนข้อมูลด้วยตนเองให้น้อยที่สุด
ตัวอย่างเช่น เมื่อประมวลผลใบแจ้งหนี้ ธุรกิจอาจต้องการข้อมูลชื่อผู้จำหน่าย หมายเลขใบแจ้งหนี้ วันที่ออกเอกสาร จำนวนภาษี และยอดเงินที่ต้องชำระ แทนที่จะให้พนักงานพิมพ์ข้อมูลแต่ละรายการด้วยตนเอง ระบบดึงข้อมูลสามารถจดจำเนื้อหาในเอกสารและจัดระเบียบฟิลด์ข้อมูลที่ต้องการให้อยู่ในรูปแบบที่มีโครงสร้างได้
เทคโนโลยีนี้มักผสานการทำงานของ Optical Character Recognition (OCR) การจำแนกประเภทเอกสาร กฎสำหรับการดึงข้อมูล และกระบวนการตรวจสอบความถูกต้องเข้าด้วยกัน
ผลลัพธ์ที่ได้จึงไม่ใช่เพียงสำเนาดิจิทัลของเอกสารต้นฉบับ แต่เป็นข้อมูลที่สามารถค้นหา ตรวจสอบ ถ่ายโอน และนำไปใช้ในการดำเนินธุรกิจได้จริง
ระบบดึงข้อมูลจากเอกสารอัตโนมัติทำงานอย่างไร?
โดยทั่วไป เวิร์กโฟลว์การดึงข้อมูลจากเอกสารอัตโนมัติประกอบด้วย 5 ขั้นตอน
- รวบรวมเอกสาร
เอกสารจะเข้าสู่กระบวนการผ่านการสแกน การอัปโหลดไฟล์ ไฟล์แนบในอีเมล หรือโฟลเดอร์ที่กำหนดไว้ รูปแบบไฟล์ที่รองรับขึ้นอยู่กับซอฟต์แวร์ที่เลือกใช้
- จดจำข้อความด้วย OCR
OCR ช่วยระบุข้อความในเอกสารที่สแกน รูปภาพ และไฟล์ประเภทอื่นที่ระบบรองรับ โดยแปลงข้อมูลที่พิมพ์อยู่ในเอกสารให้เป็นข้อความที่คอมพิวเตอร์สามารถอ่านและประมวลผลได้ รวมถึงเนื้อหาภาษาไทยและภาษาอังกฤษที่ระบบรองรับ
- ระบุและดึงข้อมูลสำคัญ
ระบบจะระบุข้อมูลที่เกี่ยวข้องกับกระบวนการทางธุรกิจ เช่น หมายเลขใบแจ้งหนี้ วันที่ รายละเอียดลูกค้า และจำนวนเงิน การดึงข้อมูลอาจใช้วิธีการที่แตกต่างกันไปตามรูปแบบการจัดวางเอกสารและความสามารถของแต่ละโซลูชัน
- ตรวจสอบความถูกต้องของข้อมูลที่ดึงออกมา
ข้อมูลที่ดึงออกมาสามารถตรวจสอบตามกฎที่กำหนดไว้ล่วงหน้า หรือให้พนักงานตรวจทานได้ ตัวอย่างเช่น ทีมการเงินอาจตรวจสอบยอดรวมในใบแจ้งหนี้และยืนยันว่ามีข้อมูลครบทุกฟิลด์ที่จำเป็นก่อนอนุมัติเอกสาร
- ส่งข้อมูลเข้าสู่ระบบธุรกิจ
เมื่อผ่านการตรวจสอบแล้ว ข้อมูลสามารถส่งออกหรือถ่ายโอนไปยังสเปรดชีต ฐานข้อมูล ซอฟต์แวร์บัญชี หรือแอปพลิเคชันอื่นที่เชื่อมต่ออยู่ได้ ช่วยลดความจำเป็นในการคัดลอกข้อมูลระหว่างระบบด้วยตนเอง
ประโยชน์สำคัญของระบบดึงข้อมูลจากเอกสารอัตโนมัติ
ลดการป้อนข้อมูลด้วยตนเอง
พนักงานใช้เวลาน้อยลงในการอ่านเอกสารและพิมพ์ข้อมูลลงในแอปพลิเคชันทางธุรกิจ ประโยชน์นี้เห็นได้ชัดเจนเป็นพิเศษในองค์กรที่ต้องประมวลผลใบแจ้งหนี้ ใบเสร็จรับเงิน และแบบฟอร์มจำนวนมาก
เพิ่มความสม่ำเสมอของข้อมูล
การดึงข้อมูลแบบมีโครงสร้างช่วยจัดระเบียบข้อมูลให้อยู่ในฟิลด์ที่มีรูปแบบสอดคล้องกัน เมื่อทำงานร่วมกับกฎการตรวจสอบความถูกต้อง ระบบจะช่วยระบุข้อมูลที่ขาดหายและข้อผิดพลาดที่อาจเกิดขึ้นก่อนส่งข้อมูลเข้าสู่ระบบในขั้นตอนถัดไป
เร่งความเร็วในการประมวลผลเอกสาร
การทำให้งานดึงข้อมูลที่ต้องทำซ้ำ ๆ เป็นระบบอัตโนมัติช่วยลดระยะเวลาในการประมวลผล และเปิดโอกาสให้พนักงานมุ่งเน้นไปที่การตรวจสอบกรณีที่มีข้อยกเว้น แทนที่จะต้องป้อนข้อมูลทุกช่องด้วยตนเอง
ทำให้เข้าถึงข้อมูลได้สะดวกยิ่งขึ้น
ข้อมูลดิจิทัลที่ผ่านการจัดโครงสร้างสามารถค้นหา เรียกดู และนำกลับมาใช้ใหม่ได้ง่ายกว่าข้อมูลที่จัดเก็บอยู่ในเอกสารกระดาษหรือไฟล์ PDF ที่มีเนื้อหาเป็นรูปภาพเพียงอย่างเดียว
สนับสนุนระบบอัตโนมัติทางธุรกิจ
เมื่อข้อมูลที่ดึงออกมาสามารถเชื่อมต่อกับแอปพลิเคชันที่มีอยู่ องค์กรจะสามารถสร้างเวิร์กโฟลว์ที่มีประสิทธิภาพมากขึ้นสำหรับงานบัญชี การจัดซื้อ งานธุรการ และการจัดการเอกสาร
อย่างไรก็ตาม ระบบอัตโนมัติไม่สามารถกำจัดข้อผิดพลาดได้ทั้งหมด ความแม่นยำของการจดจำข้อความ ความซับซ้อนของเอกสาร และข้อกำหนดในการตรวจสอบข้อมูลยังคงมีผลต่อความน่าเชื่อถือของผลลัพธ์
ตัวอย่างการใช้งานในธุรกิจ
ระบบดึงข้อมูลจากเอกสารอัตโนมัติสามารถสนับสนุนการทำงานของหลายแผนกและอุตสาหกรรม
- บัญชีและการเงิน: ดึงรายละเอียดผู้จำหน่าย หมายเลขใบแจ้งหนี้ วันที่ และจำนวนเงิน เพื่อสนับสนุนการประมวลผลใบแจ้งหนี้และการจัดการค่าใช้จ่าย
- จัดซื้อ:รวบรวมรายละเอียดใบสั่งซื้อและข้อมูลผู้จำหน่าย เพื่อลดการป้อนข้อมูลซ้ำและสนับสนุนการจับคู่เอกสาร
- ทรัพยากรบุคคล: ดึงข้อมูลจากแบบฟอร์มใบสมัครและเอกสารพนักงาน เพื่อให้กระบวนการบริหารจัดการด้านทรัพยากรบุคคลง่ายขึ้น
- งานธุรการด้านการแพทย์: แปลงข้อมูลจากแบบฟอร์มและบันทึกต่าง ๆ ให้เป็นข้อมูลดิจิทัล โดยมีการตรวจสอบความถูกต้องและปกป้องข้อมูลที่มีความอ่อนไหวอย่างเหมาะสม
- การจัดการเอกสาร: เปลี่ยนข้อมูลจากสัญญา รายงาน และเอกสารย้อนหลังที่ผ่านการสแกนให้เป็นเนื้อหาดิจิทัลที่ค้นหาได้
การเลือกกรณีใช้งานที่เหมาะสมที่สุดขึ้นอยู่กับปริมาณเอกสาร ฟิลด์ข้อมูลที่ต้องการ รูปแบบเอกสาร และระดับความแม่นยำที่จำเป็น
DOVA OCR สนับสนุนการดึงข้อมูลจากเอกสารอัตโนมัติอย่างไร?
DOVA OCR ช่วยให้องค์กรเปลี่ยนเนื้อหาในเอกสารให้เป็นข้อมูลดิจิทัลที่พร้อมใช้งาน ผ่านความสามารถด้าน OCR และการประมวลผลเอกสาร
ดึงข้อมูลที่มีโครงสร้าง
DOVA OCR ไม่ได้หยุดอยู่เพียงการจดจำข้อความ แต่ยังรองรับการดึงข้อมูลที่เกี่ยวข้องจากเอกสาร ช่วยลดภาระในการถ่ายโอนข้อมูลแต่ละฟิลด์ไปยังระบบอื่นด้วยตนเอง
จำแนกประเภทเอกสาร
การจำแนกประเภทเอกสารช่วยจัดระเบียบไฟล์ที่ได้รับเข้ามาตามประเภท ทำให้ธุรกิจสามารถจัดการใบแจ้งหนี้ แบบฟอร์ม และเอกสารอื่น ๆ ตามเวิร์กโฟลว์ที่เหมาะสมกับแต่ละประเภทได้
ตรวจสอบข้อมูลที่ดึงออกมา
DOVA OCR มีความสามารถในการตรวจสอบข้อมูล ช่วยให้พนักงานทบทวนข้อมูลที่ระบบดึงออกมาและระบุข้อผิดพลาดที่อาจเกิดขึ้นก่อนดำเนินการในขั้นตอนต่อไป ซึ่งมีความสำคัญอย่างยิ่งสำหรับตัวเลขทางการเงินและข้อมูลสำคัญอื่น ๆ ของธุรกิจ
เชื่อมต่อกับเวิร์กโฟลว์ที่มีอยู่
DOVA OCR รองรับความสามารถต่าง ๆ เช่น การส่งออกไฟล์ CSV การจัดเก็บข้อมูลในฐานข้อมูล และ RESTful API ทั้งนี้ ขึ้นอยู่กับข้อกำหนดในการติดตั้งใช้งาน ตัวเลือกเหล่านี้สามารถช่วยส่งข้อมูลที่ดึงออกมาเข้าสู่ระบบธุรกิจที่มีอยู่ และลดการถ่ายโอนข้อมูลซ้ำด้วยตนเอง
เพิ่มประสิทธิภาพในการดำเนินงาน
การผสานการจดจำข้อความ การดึงข้อมูล การตรวจสอบ และการเชื่อมต่อระบบเข้าด้วยกัน ช่วยให้ธุรกิจสร้างกระบวนการทำงานที่มีความสม่ำเสมอมากขึ้น ตั้งแต่การรับเอกสารไปจนถึงการได้ข้อมูลที่พร้อมใช้งานจริง
ประโยชน์ที่ได้รับขึ้นอยู่กับคุณภาพของเอกสาร การออกแบบเวิร์กโฟลว์ และข้อกำหนดในการเชื่อมต่อระบบของแต่ละองค์กร
วิธีเลือกโซลูชันดึงข้อมูลจากเอกสารที่เหมาะสม
ก่อนนำระบบดึงข้อมูลอัตโนมัติมาใช้งาน ธุรกิจควรประเมินความต้องการในการประมวลผลเอกสารของตนเองอย่างรอบคอบ
เริ่มต้นด้วยการระบุประเภทเอกสารที่ต้องใช้แรงงานในการจัดการมากที่สุด จากนั้นทดลองใช้โซลูชันกับเอกสารจริง รวมถึงเอกสารสแกนที่มีคุณภาพต่ำและเอกสารที่มีรูปแบบการจัดวางแตกต่างกัน พร้อมวัดความแม่นยำของฟิลด์ข้อมูลที่สำคัญ
นอกจากนี้ ควรพิจารณาว่าระบบรองรับภาษาไทยและภาษาอังกฤษหรือไม่ มีเครื่องมือสำหรับตรวจสอบข้อมูลหรือไม่ สามารถเชื่อมต่อกับแอปพลิเคชันที่ใช้งานอยู่ได้หรือไม่ ตรงตามข้อกำหนดด้านความปลอดภัยหรือไม่ และรองรับปริมาณเอกสารที่คาดว่าจะเกิดขึ้นได้เพียงพอหรือไม่
การทดลองใช้งานในโครงการนำร่อง (Pilot Project) เป็นแนวทางที่ช่วยวัดระยะเวลาในการประมวลผล อัตราการแก้ไขข้อมูล และการปรับปรุงประสิทธิภาพโดยรวม ก่อนขยายการใช้ระบบอัตโนมัติไปยังส่วนอื่น ๆ ขององค์กร
สรุป
ระบบดึงข้อมูลจากเอกสารอัตโนมัติช่วยให้ธุรกิจเปลี่ยนข้อมูลที่อยู่ในเอกสารให้เป็นข้อมูลที่มีโครงสร้าง สามารถค้นหา ตรวจสอบ และนำไปใช้ในเวิร์กโฟลว์ดิจิทัลได้ การลดการป้อนข้อมูลด้วยตนเองและเชื่อมต่อข้อมูลที่ดึงออกมากับแอปพลิเคชันทางธุรกิจช่วยให้องค์กรเพิ่มประสิทธิภาพและจัดการกระบวนการทำงานที่เกี่ยวข้องกับเอกสารจำนวนมากได้ดียิ่งขึ้น
ระบบดึงข้อมูลจากเอกสารอัตโนมัติ ที่มีประสิทธิภาพควรทำได้มากกว่าการจดจำข้อความ โดยต้องสามารถระบุฟิลด์ข้อมูลที่เกี่ยวข้อง รองรับการตรวจสอบความถูกต้อง และช่วยส่งต่อข้อมูลไปยังระบบที่จำเป็นต้องใช้งานได้
DOVA OCR ผสานการจดจำเอกสารเข้ากับความสามารถในการดึงข้อมูล จำแนกประเภท ตรวจสอบ และเชื่อมต่อระบบ เพื่อสนับสนุนกระบวนการดังกล่าว ธุรกิจสามารถศึกษารายละเอียดและทดลองประเมินความเหมาะสมของ DOVA OCR โดยใช้เอกสารจริงและข้อกำหนดของเวิร์กโฟลว์ภายในองค์กรเป็นเกณฑ์ในการตัดสินใจ